


 Zdieľať na Facebooku
 Zdieľať na Twittri
Query fan-out (po slovensky rozvetvenie dopytu) je technika, pri ktorej sa hlavný dopyt (query) automaticky rozloží na viacero odvodených dopytov (subqueries) tak, aby sa pokryl širší kontext, rôzne zámery používateľa a získali sa presnejšie podklady pre AI odpoveď.
Všetkému rozumieš a potrebuješ len query fan-out nástroj? Páči sa: QueryTool.ai
Ak sa v Google AI režime spýtate „čo je seo?“, na pozadí si špeciálne upravený model Gemini vyhľadá zhruba takéto výrazy: čo je seo definícia, význam seo pre firmy, základné piliere seo, hlavné súčasti seo, on-page seo, off-page seo. Je to, ako by ste si v klasickom Googli vyhľadali niekoľko výrazov naraz.
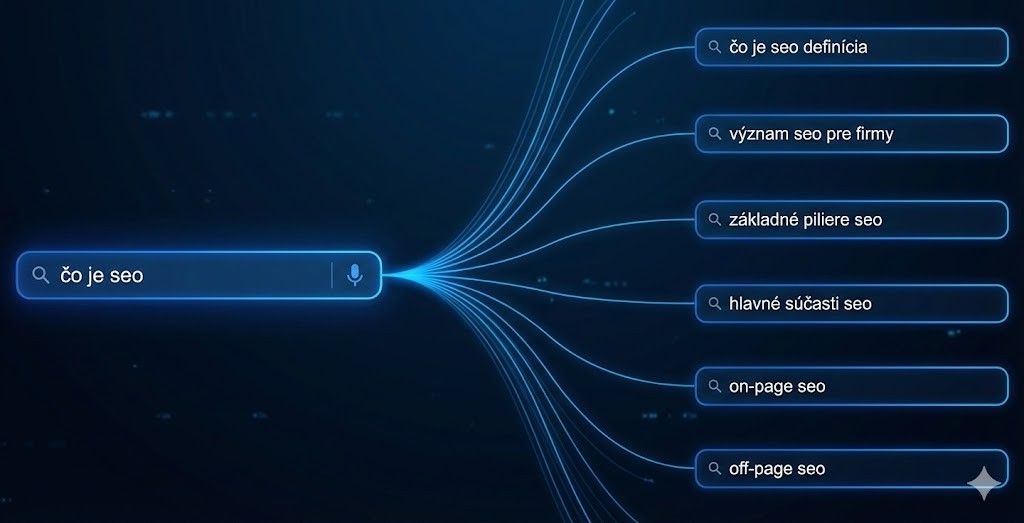
Na základe týchto čiastkových hľadaní si AI nájde zdroje (webové stránky, videá, informácie na Google mapách, atď.) a z nich skompiluje svoju odpoveď používateľovi.
Pre používateľa to má dve zásadné výhody:
- Šetrí to čas. Človeku by trvalo omnoho dlhšie všetky tieto výrazy vyhľadať, zdroje prečítať a tému navnímať.
- AI hľadá aj výrazy, ktoré by človeku nenapadli. Bežný používateľ hľadajúci „čo je seo“ nevie, že by si mal vyhľadať aj „on-page seo“ alebo „off-page seo“. AI už ale nejaké veci „vie“ a teda vie, aké pokročilejšie výrazy a informácie potrebuje pre odpoveď používateľovi.
Google o tejto technike hovoril koncom mája na I/O 2025:
Query fan-out a grounding
Query fan-out je súčasťou procesu, ktorý voláme ukotvenie, resp. grounding. Samotný veľký jazykový model (LLM), na ktorom AI beží, si často vymýšľa a zo svojej podstaty nevie overiť, či to, čo generuje, je naozaj pravda. Hovoríme tomu AI halucinácie.
Grounding je proces, pri ktorom sa AI využije „len“ na to, aby zhrnulo informácie z webových stránok alebo iných zdrojov, čím sa výrazne zníži miera halucinácií v AI odpovediach.
AI pritom väčšinou nečíta celú stránku, ale skôr ako človek skenuje a hľadá len relevantné pasáže stránky pre svoju odpoveď. Voláme ich chunks. Chunk býva jeden-dva odseky, niekedy len jedna veta, zoznam, sekcia s nadpisom alebo kus tabuľky. Systém si stránku rozdelí na takéto chunks, porovná chunks s otázkou a vyberie len tie najrelevantnejšie. Z nich potom model skladá odpoveď.
Pri AI SEO optimalizujeme okrem celých stránok, aj vybrané pasáže stránok.
Okrem AI halucinácií grounding rieši aj aktuálnosť informácií. Každý natrénovaný jazykový model má tzv. cut-off date, t.j. dátum, kedy sa ukončil zber dát pre jeho trénovanie. Po tomto dátume jazykový model nevie o svete nič, pretože informácie po tomto dátume už neboli použité pre jeho trénovanie. Ale ak AI využije na pozadí vyhľadávanie (grounding), tak si aktuálne informácie vie dohľadať a vie správne odpovedať aj na otázky, kde je aktuálnosť dôležitá.
Preto každé dobré AI určite použije grounding, ak sa ho pýtate na novinky a trendy. Ale niektoré dôležité AI, napríklad Google AI Overviews, použije grounding vždy, aj na otázky, ktoré nie sú na aktuálne informácie.
Ako sa dostať do AI odpovede?
Do AI odpovedí sa dá dostať dvomi spôsobmi – ako zdroj informácie alebo ako entita v odpovedi.
Ako zdroj informácie
Ak sa vaša stránka zdá relevantná pre niektorý z poddopytov (subquery) hľadaných pri query fan-out procese, AI z nej čerpá informácie a spomenie ju ako zdroj danej informácie. Zdrojom pritom nemusí byť celá stránka, môže to byť len časť vašej stránky, alebo vaše video na Youtube, obrázok, zápis na Google mapách, zdrojov je mnoho.
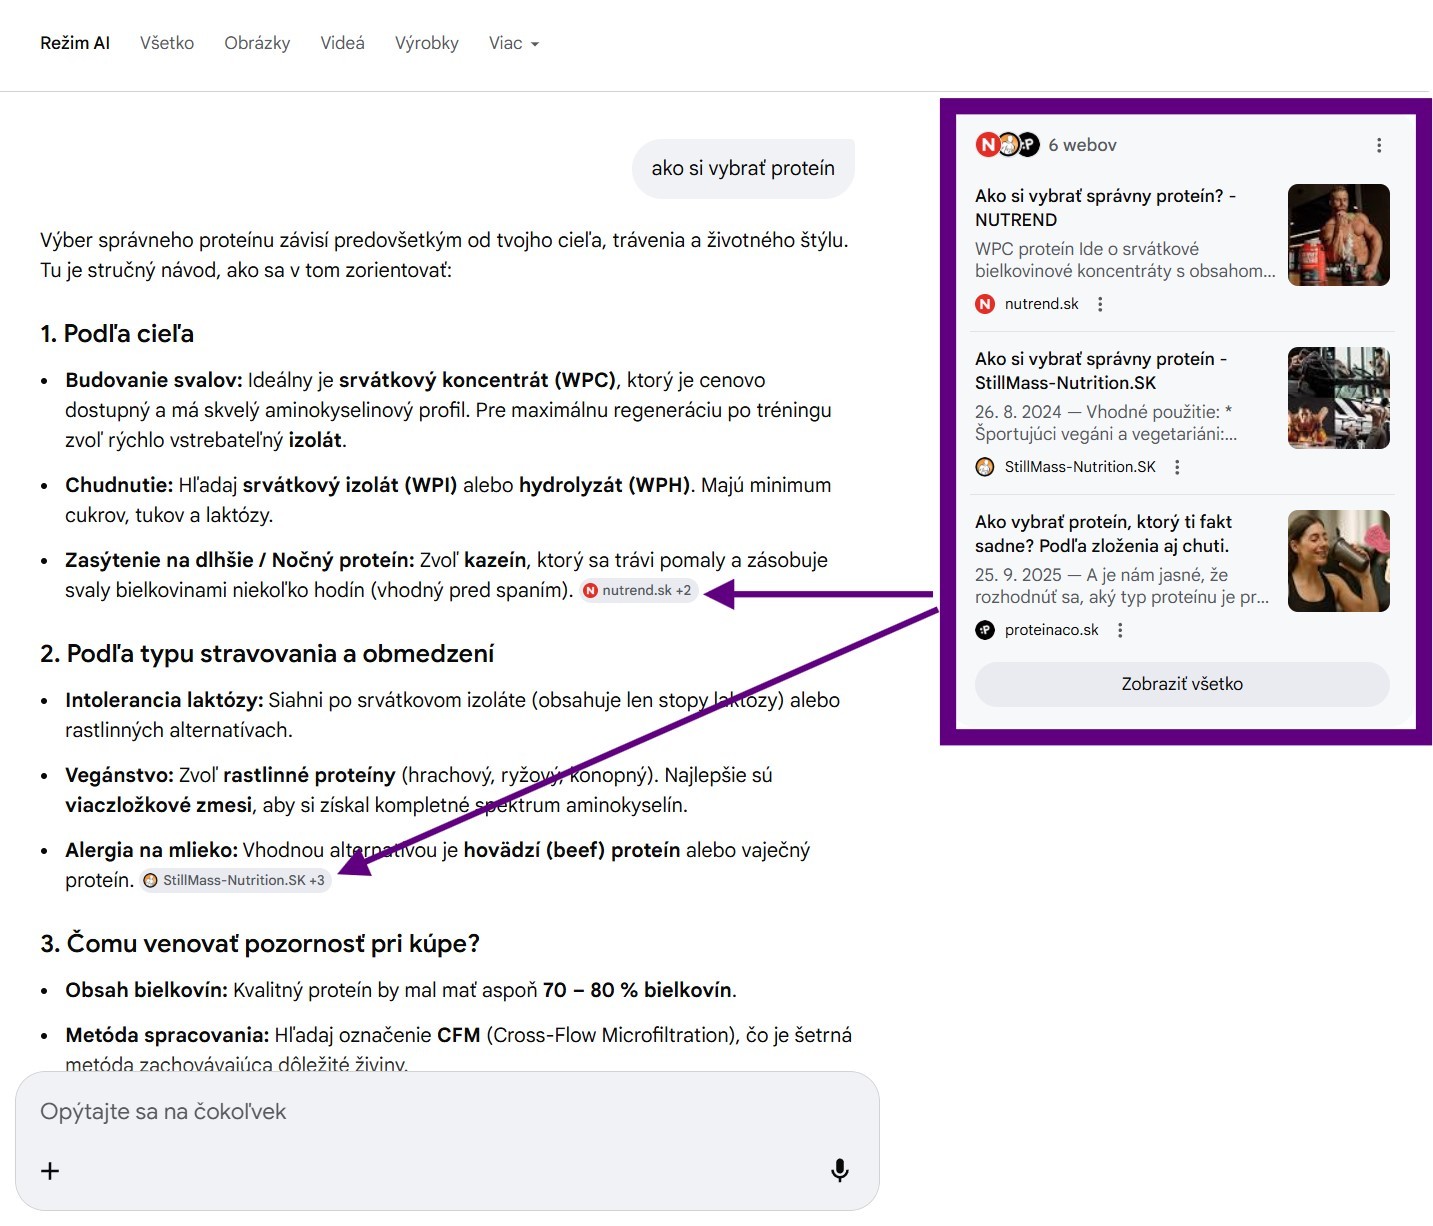
Na zdroje klikajú ľudia oveľa menej ako na klasické výsledky, veď AI im tú hlavnú odpoveď dalo a môžu sa dopýtať na ďalšie detaily. Ale prirovnal by som to k takému lepšiemu billboardu – chcete tam na svoje témy byť, pretože to podporuje branding.
Väčšinou sa ako zdroj chceme umiestniť na informačné výrazy súvisiace s naším podnikaním.
Ako entita v odpovedi
Ak sa niekto spýta AI niečo komerčného charakteru, napr. „kde si kúpiť proteín“ (notebook, matrac, čokoľvek), najdôležitejšie pre nás je, aby nás AI priamo odporúčalo vo svojej odpovedi.
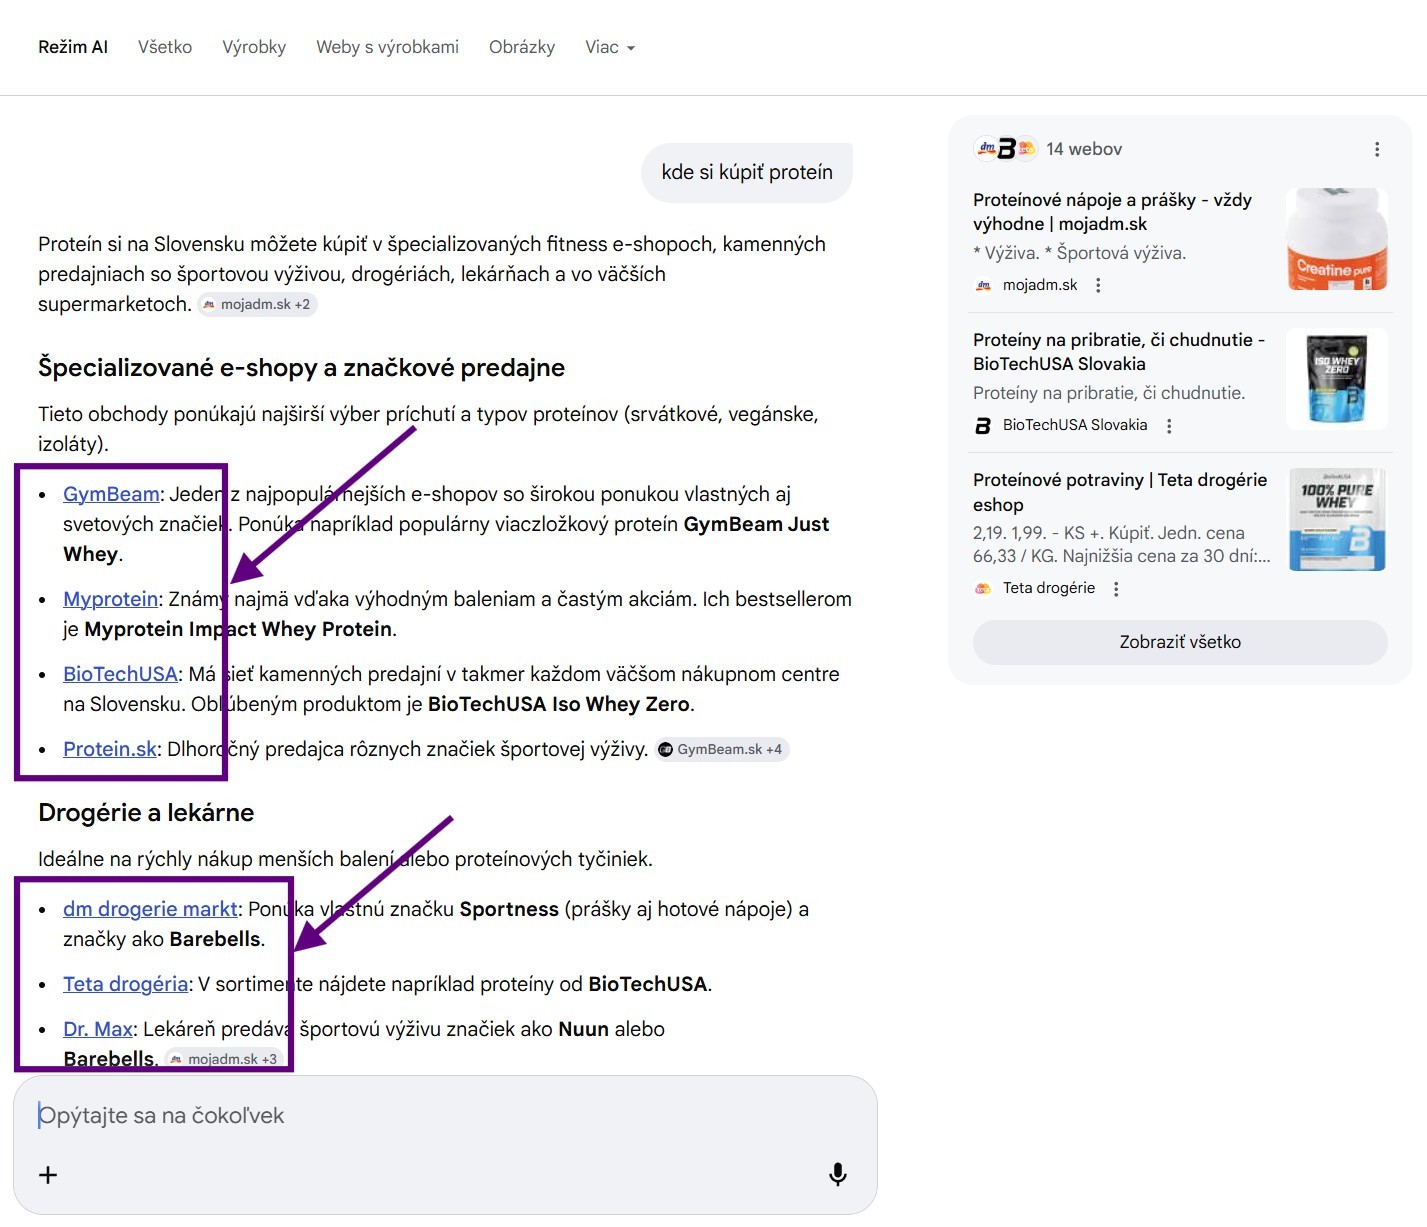
Lenže na to, aby nás odporúčalo, musíme splniť aspoň jedno:
- Byť priamo v natrénovaných dátach LLM, aby nás AI mohlo odporučiť “z pamäti”. Toto s query fan-out procesom až tak nesúvisí. O tom, odkiaľ sa berú dáta pre trénovanie LLM možno niekedy inokedy.
- Byť v zdrojoch, z ktorých AI čerpá. Toto priamo súvisí s query fan-out-om, pretože zdroje AI nachádza pomocou čiastkových hľadaní.
Niektoré subqueries cielime tvorbou vlastného obsahu
Niektoré subqueries chceme pokryť vlastnými stránkami. Napríklad ak vidíte, že si AI hľadá výraz “tipy na cestovanie v Japonsku”, potom tento výraz zacielime samostatnou stránkou. Ak vidíme, že si AI hľadá “najlepší čas na návštevu Japonska”, tak sa tomu môžeme venovať v samostatnom článku, alebo to môžeme cieliť časťou stránky (tzv. chunk), napr. toho článku o “tipoch na cestovanie v Japonsku”.
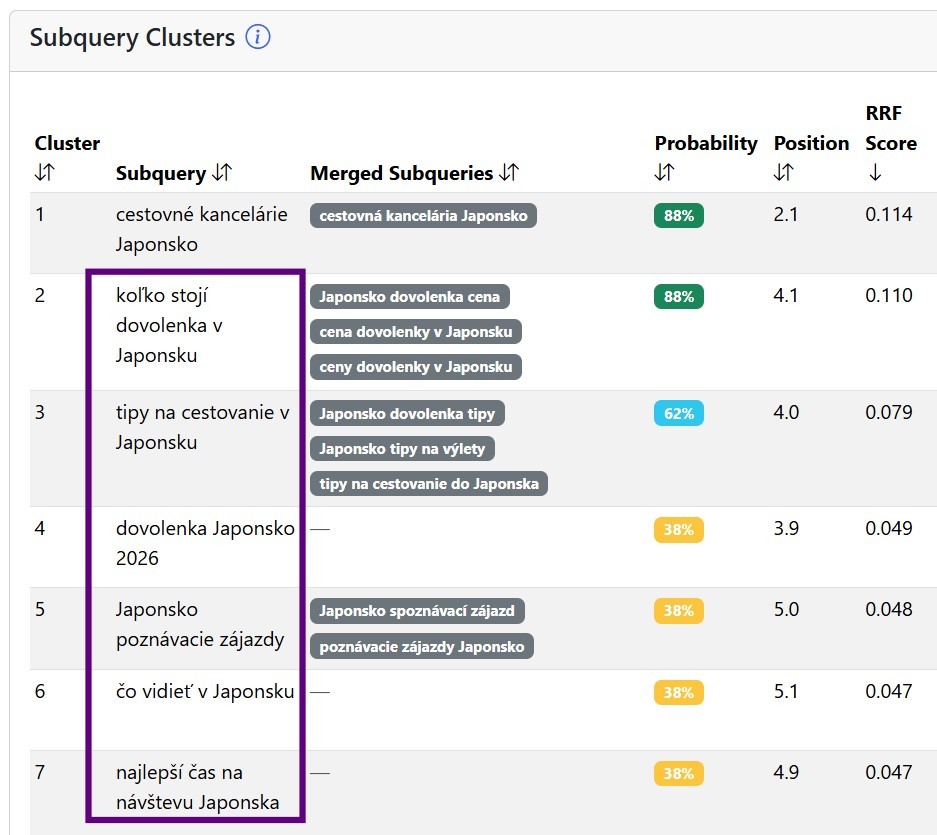
Ale nie všetky výrazy je rozumné takto cieliť.
Niektoré subqueries cielime reputačným manažmentom
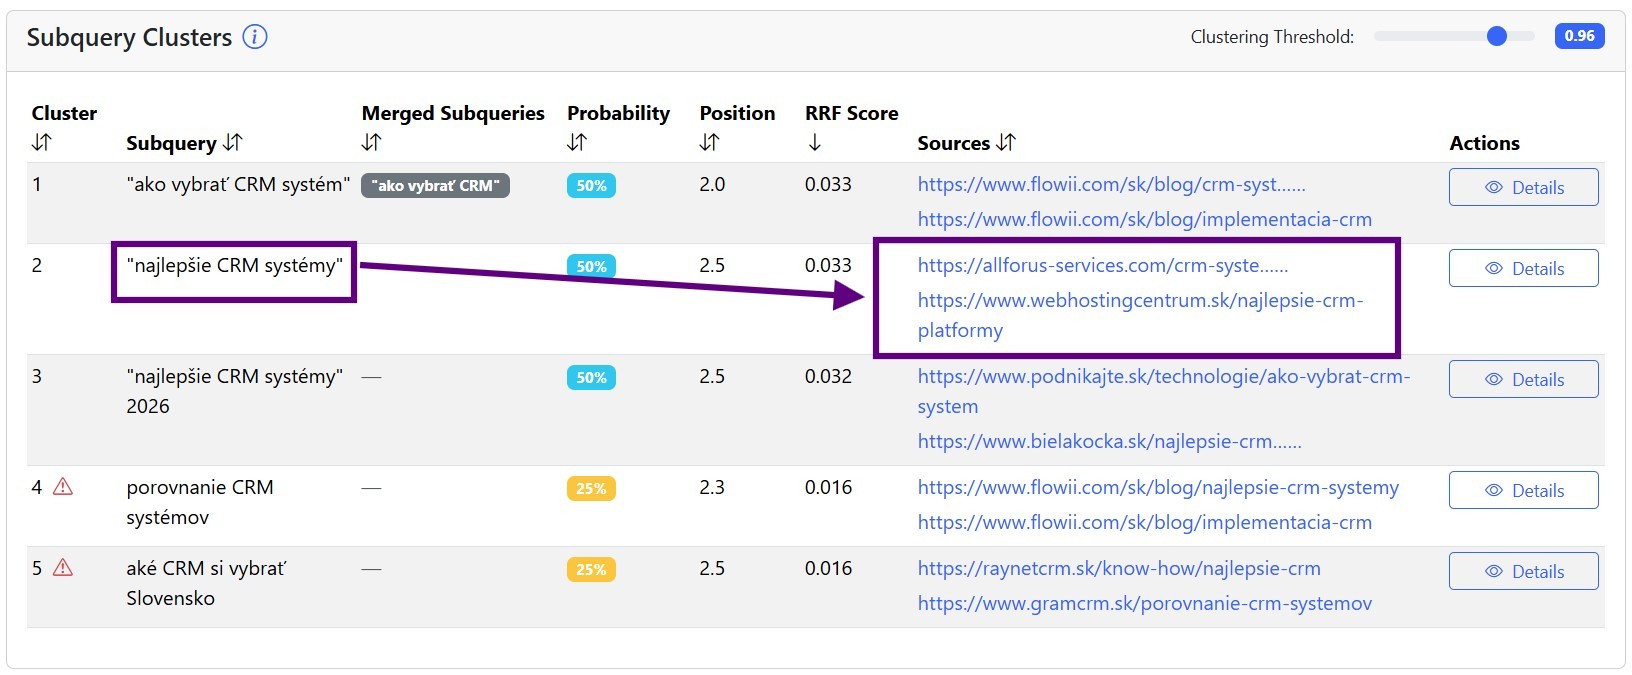
Ak si AI hľadá subquery “cestovné kancelárie japonsko” alebo “najlepšie CRM systémy”, chce nájsť porovnania u tretích strán. Napísať vlastný článok Najlepšie CRM systémy a umiestniť seba ako TOP nie je práve najšťastnejšie. Mnoho webov to robí, resp. robilo, volá sa to self-promoting listicles (sebapropagujúce zoznamy?). Google takéto selfpromo články v poslednej dobe začal riešiť v podstate ako spam.
S výrazmi “najlepšie CRM systémy” robíme niečo omnoho rozumnejšie. Oslovujeme stránky, ktoré na tento výraz AI používa ako zdroj a snažíme sa ich presvedčiť, aby sme na ich stránke boli spomenutí a ešte v dobrom kontexte.
Čo je query fan-out analýza?
Query fan-out analýzou teda hľadáme a priorizujeme príležitosti pre:
- Nový obsah alebo vylepšenie obsahu, ktorý odpovie na subquery, veľmi podobne, ako sme to robili pri klasických kľúčových slovách a klasickom SEO.
- Hľadáme externé zdroje, z ktorých čerpá odpovede AI a v ktorých nie sme spomenutí, alebo nie v želanom kontexte.
Pri AI SEO potrebujeme vedieť, aké výrazy AI hľadá, keď sa ho spýtame naše kľúčové prompty.
Chápete, kľúčové slová (keywords) a kľúčové prompty (key prompts).
Ak ste niekedy robili analýzu kľúčových slov, tak je pochopenie query fan-out analýzy jednoduché.
Pri analýze kľúčových slov mapujeme, čo hľadajú ľudia. Pri query fan-out analýze mapujeme, čo hľadá AI.
Sčasti sa hľadané výrazy prekrývajú, ale AI hľadá aj výrazy, ktoré ľudia nie. Jednoducho preto, že o každej téme vie viac ako priemerný človek a preto, že je pre AI veľmi jednoduché pridať ďalšie hľadanie nejakého poddopytu.
Na to, aby sme zistili, aké výrazy hľadá AI, potrebujeme nástroj.
Primitívny vs reálny query fan-out
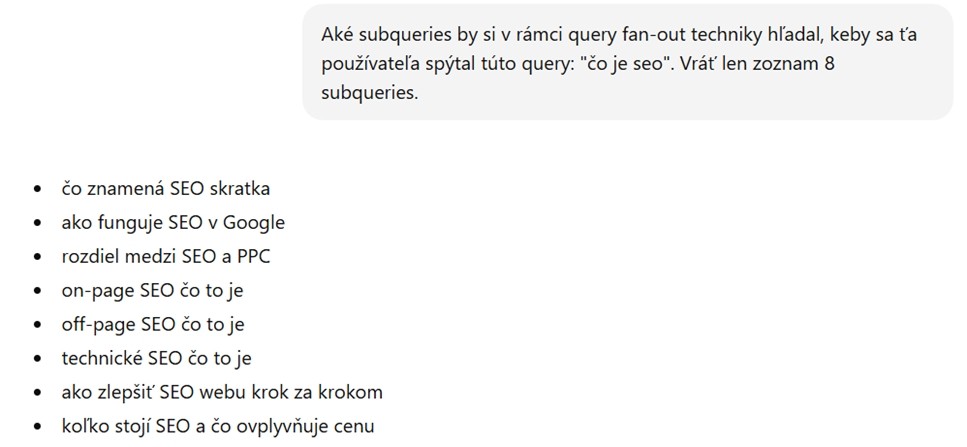
Väčšina query fan-out nástrojov robí niečo, čo volám primitívny query fan-out. V zásade tie nástroje ani nepotrebujete, pretože si ich viete nasimulovať sami. Stačí, že sa AI, pre ktoré vás query fan-out zaujíma, spýtate niečo ako:
Výstup bude vyzerať nejak takto:
Nie každý prompt spustí query fan-out
Vyzerá to všetko krásne a logicky. Problém je, že keď sa ChatGPT vyššie uvedenú otázku naozaj spýtate, tak žiadny query fan-out neurobí a odpovie takpovediac z pamäte. Primitívnym query fan-outom neviete zistiť, či AI naozaj využíva grounding pri danom prompte alebo query.
To sa dá ako tak obísť tým, že by ste sa najprv spýtali, či by AI vôbec pre dané query použilo grounding. Ale aj keby ste to skúšali na prompt, kde určite grounding bude, napríklad „zhrň mi posledné seo novinky“, zistíte, že ten zoznam nie je úplne ten, čo sa reálne vyhľadá.
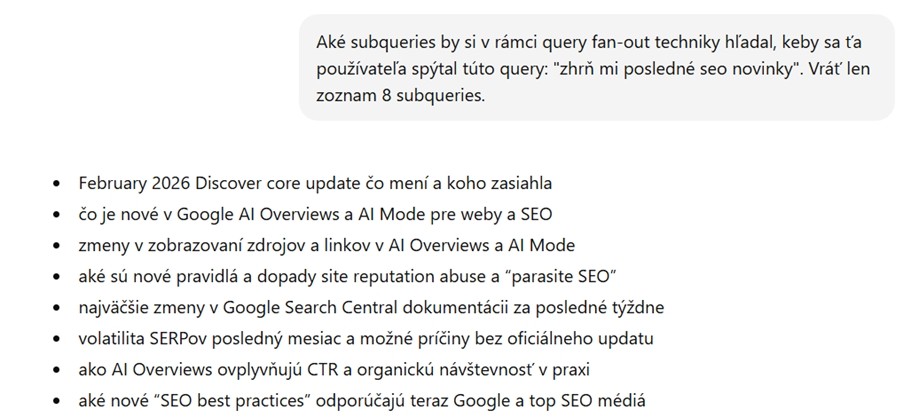
Mám naprogramované rozšírenie do Google Chrome-u, ktoré mi ukáže reálne vyhľádávané výrazy ChatGPT a v skutočnosti na tento prompt ChatGPT hľadalo toto:
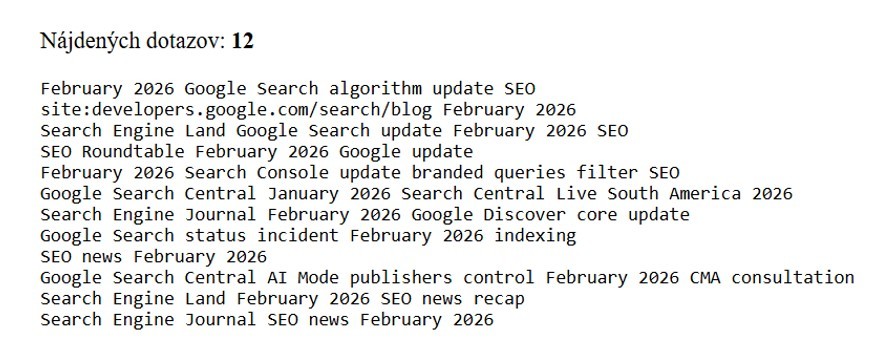
Ako je vidno, ChatGPT hľadalo po anglicky v domnení, že nájde viac info a následne mi to po slovensky zhrnie. Aj toto by sa dalo obísť vylepšením promptu. Ale jedna vec sa nedá nijako obísť.
Nájdený obsah ovplyvňuje ďalšie subqueries
Informácie, ktoré našlo ChatGPT na predošlý výraz môžu ovplyvniť následné hľadané subqueries. To znamená, že to nefunguje tak, že si ChatGPT dopredu povie, čo všetko bude hľadať. Najprv si niečo vyhľadá, nájde informácie a na základe nájdených informácií si dohľadá niečo ďalšie. Teda obsah, ktorý našiel, ovplyvňuje, aké budú ďalšie hľadané poddopyty.
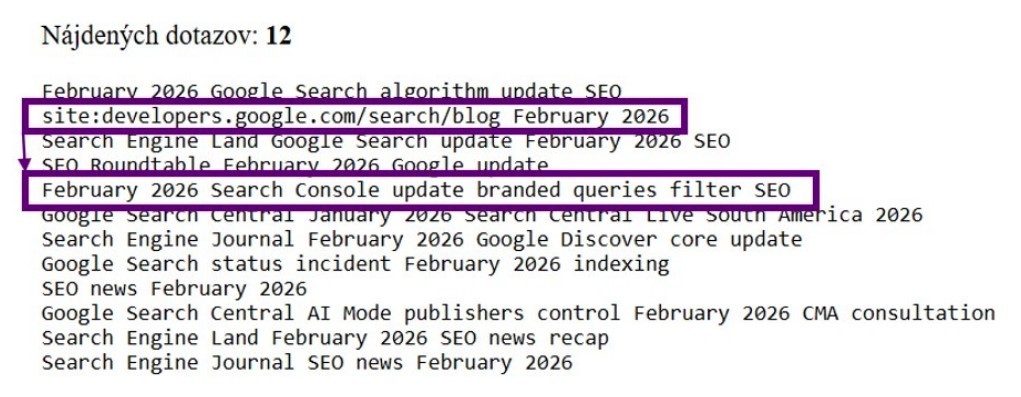
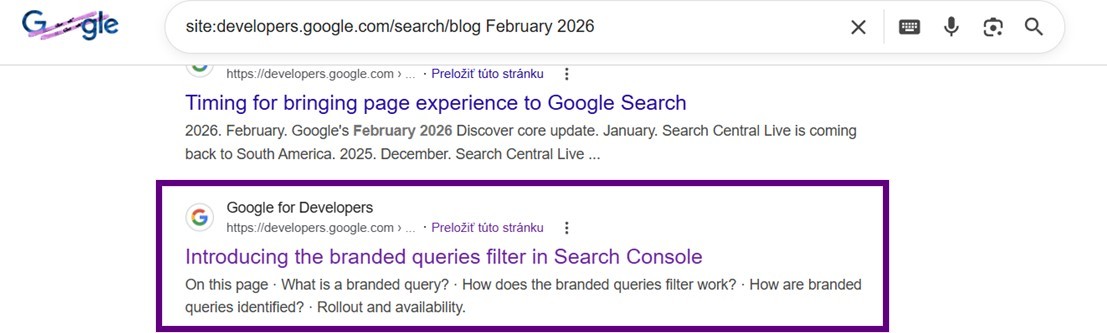
Všimnite si výraz „February 2026 Search Console update branded queries filter SEO“. Sám od seba nemohol vedieť, že má hľadať nejaký branded queries filter v Google Search Console. Nemohol vedieť, že sa to aktuálne rieši. Model GPT to nemá v natrénovaných dátach. Zistil to, až keď si vyhľadal tento výraz „site:developers.google.com/search/blog February 2026“.
Viď, že aj na Googli je to jedna z top tém na dané hľadanie:
To znamená, že bez simulácie celého procesu AI odpovede neprídete k dobrému zoznamu hľadaných subqueries.
Jedna simulácia nestačí
A navyše jedna simulácia nestačí. Keď sa AI spýtate opakovane to isté, zistíte, že AI si vždy vyhľadá trochu iné výrazy a dá trochu inú odpoveď. To “trochu” je niekedy viac a niekedy menej a dá sa presne zmerať, ale o tom niekedy inokedy.
Čiže ak budete vychádzať z jednej simulácie, budete:
- Cieliť výrazy, ktoré mohli byť len v tej jednej simulácii a nikomu inému sa už nepoužijú. Inými slovami strata času.
- Nebudete poznať priority hľadaných subqueries. Všetky subqueries vyzerajú pri jednej simulácii rovnako dôležito (teda okrem ich poradia). Ale ako zistíme, niektoré výrazy sú dôležitejšie ako iné.
Ako to rieši QueryTool.ai?
Na opakované simulácie sme postavili vlastný query fan-out nástroj QueryTool.ai.
QueryTool.ai nechá AI odpovedať na prompt niekoľkokrát, zakaždým odchytí použité subqueries a podľa ich frekvencie výskytu vypočíta pravdepodobnosť toho, že sa objavia v query fan-out procese.
AI si teda niekoľkokrát spraví query fan-out pre ten istý prompt, ale vždy pritom vyhľadá trochu iné výrazy, stiahne trochu iné zdroje a skompiluje trochu inú odpoveď. Tieto výstupy potom QueryTool.ai analyzuje.
QueryTool.ai má vyladený prístup cez API tak, aby sa výsledky podobali na tie reálne výsledky, ktoré nájdeme v danom AI prostredí, napr. Google AI Mode alebo ChatGPT. Používame ho od júna 2025 a pokiaľ viem, žiaden nástroj na trhu to takto dodnes nerobí.
Výstup na query kde si kúpiť komiks vyzerá takto:
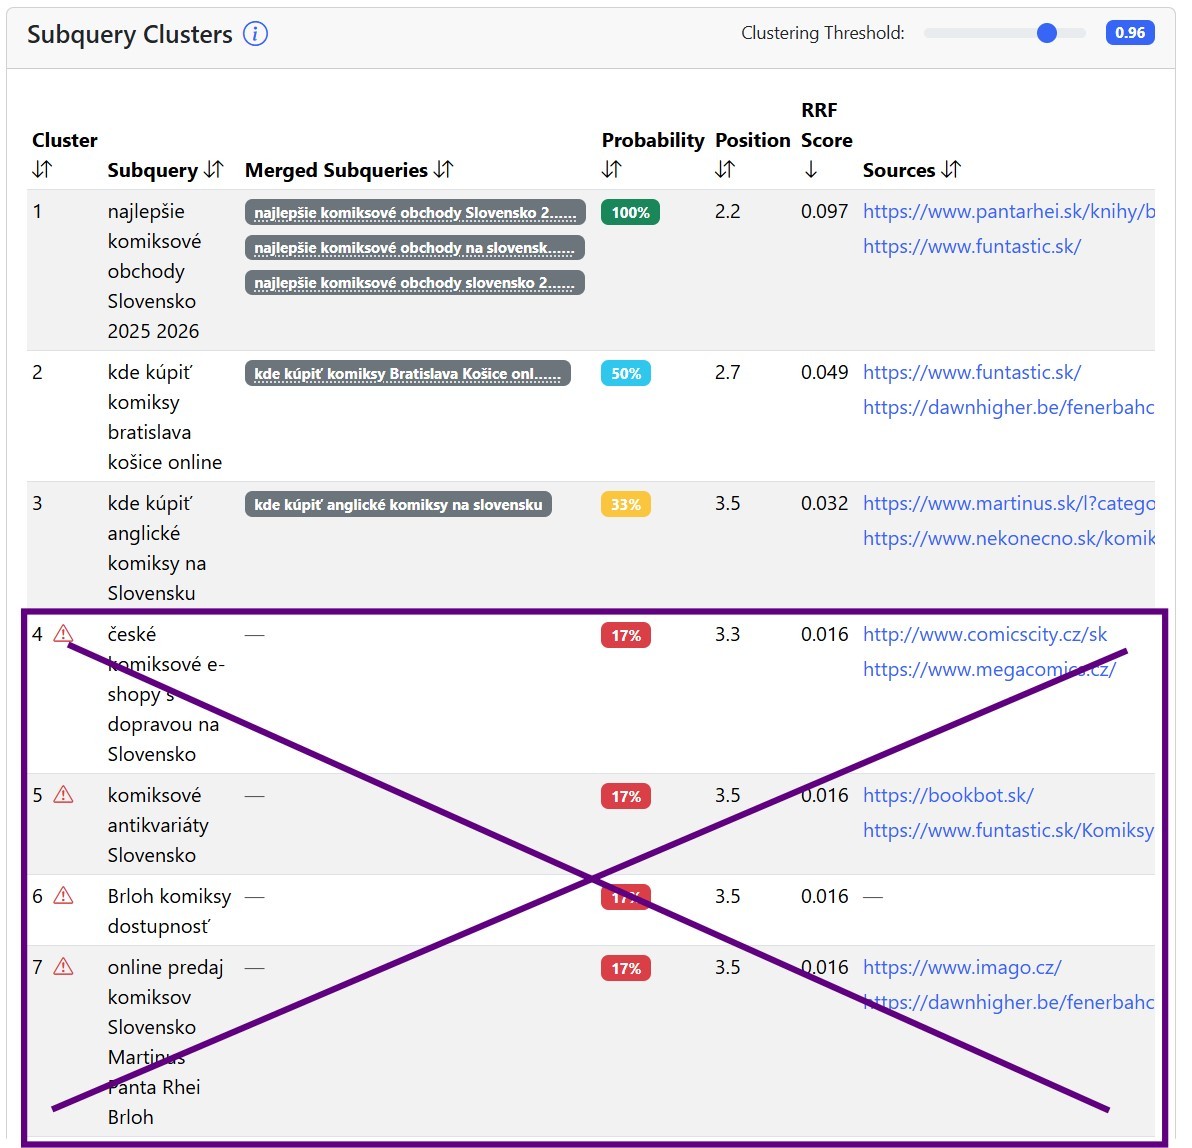
Preškrtnuté výrazy sú tie, ktoré sa ukázali len v jednom zo 7 pokusov. Sú to teda tie, ktoré sú len náhodné a nebudeme sa unúvať ich cieliť.
Pravdepodobnosť je naše nové KPI
Aj keď sa cena za tvorbu dobrého obsahu vďaka AI nástrojom výrazne znížila, stále je príliš vysoká na to, aby sme si mohli dovoliť naháňať výrazy, ktoré sú náhodné. Tzn. potrebujeme priorizovať výrazy podľa toho, ako pravdepodobné je, že tie poddopyty AI vyhľadá na náš hlavný výraz.
Ako sme si už písali, robíme to tak, že sa AI spýtame opakovane to isté. Necháme ho zakaždým spraviť si query fan-out a následne odchytíme reálne hľadané výrazy. Nazvime jedno spýtanie sa beh alebo run.
Odchytené poddopyty v X behoch zoskupujeme podľa významu – clusterujeme. Niekedy sa poddopyty líšia len vo veľkých a malých písmenách, poradí slov, alebo sú to síce iné slová, ale vyjadrujú to isté. Vyhodnocujeme, v koľkých behoch sa daný výraz, resp. jeho cluster objavil. Na výstupe je to stĺpec Probability.
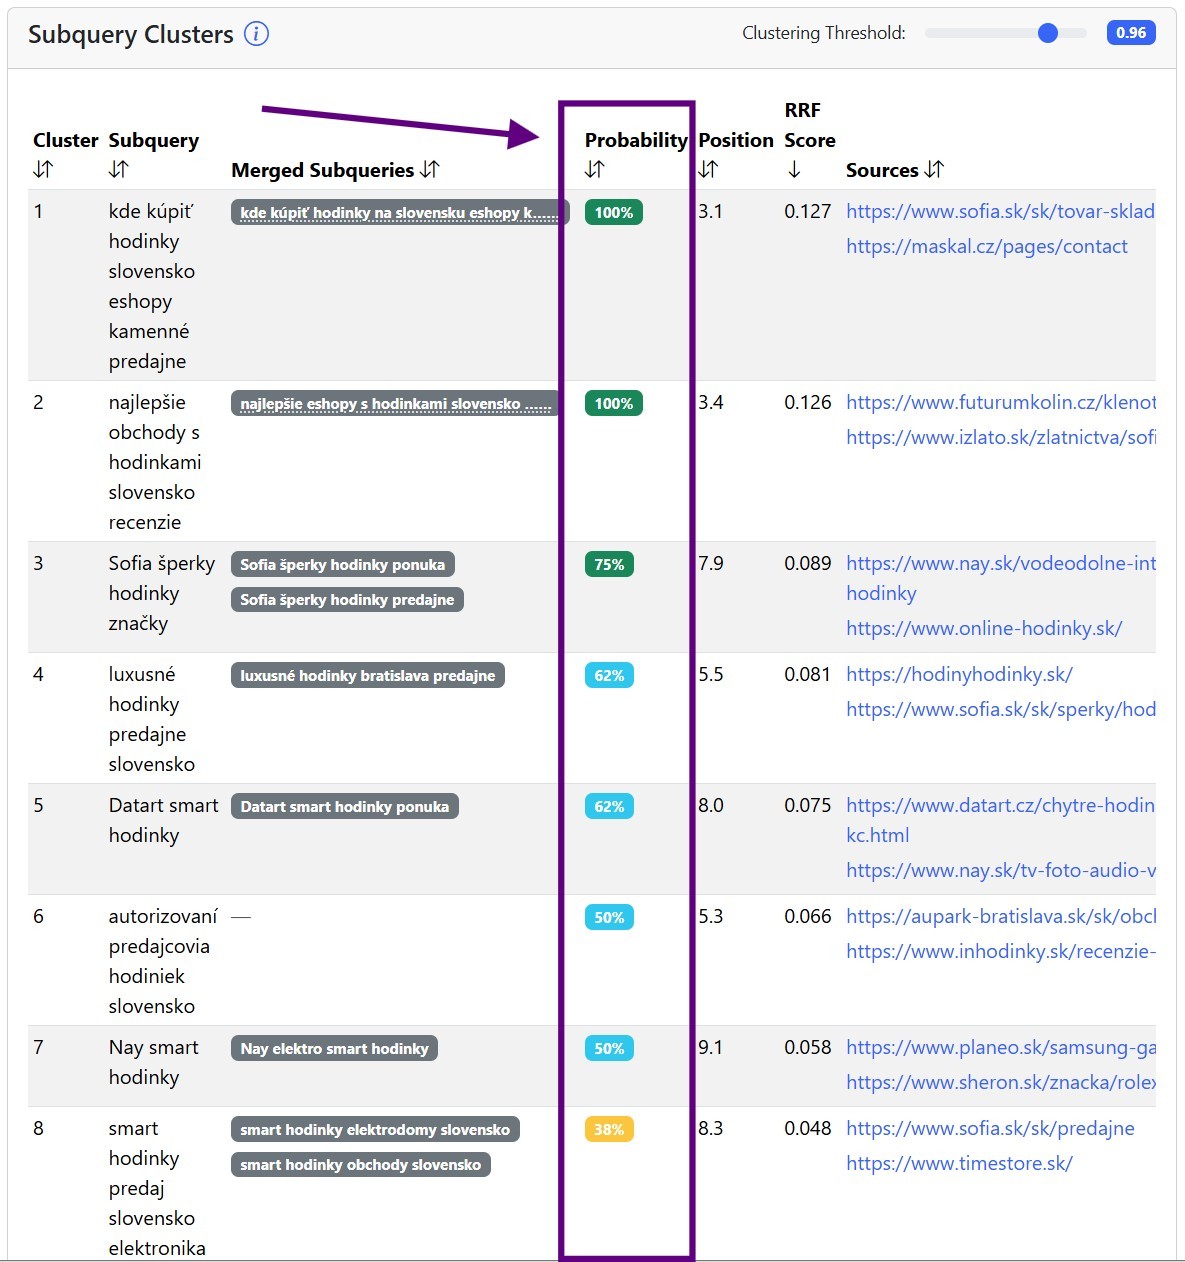
Druhá metrika, ktorú sledujeme, je priemerná pozícia. V prípade subqueries je to priemer toho, koľký hľadaný výraz to bol v rámci jednotlivých behov. Ak sú totiž 2 výrazy, ktoré sa hľadajú v každom behu, teda majú 100% pravdepodobnosť hľadania, tak nás zaujíma, ktorý zvykne byť prvý. Ten je dôležitejší, keďže asi viac ovplyvní nájdené zdroje. Na screeenshote vyššie je to metrika Position.
No a potom máme skóre, ktoré zohľadňuje aj pravdepodobnosť aj priemernú pozíciu, voláme ho RRF skóre, keďže je inšpirované pôvodným RRF skóre (Reciprocal Rank Fusion Score). O tom, ako sa počíta, si môžete prečítať v mnohých článkoch, ale nateraz stačí vedieť toľko, že najlepšie radenie priority subqueries je podľa RRF skóre, lebo zahŕňa info aj o pravdepodobnosti, aj o pozícii.
Ak sme pri kľúčových slovách riešili ich hľadanosti, tak pri subqueries riešime ich pravdepodobnosti.
Zdroje v rámci query fan-out procesu
Okrem subqueries chceme pri query fan-out simulácii zistiť, ktoré zdroje sa s najväčšou pravdepodobnosťou použijú pri groundingu. Tieto zdroje nás informujú o tom:
- Aký obsah sa presadí na jednotlivé výrazy. Querytool.ai napáruje zdroje na jednotlivé subqueries a potom vieme, ktoré zdroje na daný výraz sú naši konkurenti. Ako keby ste si pozreli TOP pozície na vaše kľúčové slovo v klasickom Google vyhľadávaní. Vidíte subquery a k nemu zdroje, ktoré si AI na daný výraz vybral.
- Kde sa chceme zobraziť na výrazy, ktoré vyžadujú tretiu stranu. Napr. ak sa zdroj ukazuje na výraz „najlepšie SEO služby“, tak to nepokryjeme vlastným článkom, ale tým, že zistíme zdroje, ktoré sa na daný výraz dostanú do AI a budeme sa tam chcieť zobraziť v dobrom kontexte.
Ako sa dajú analyzovať zdroje
Podľa URL a domény za všetky poddopyty. Jedna doména má často niekoľko URL, ktoré sa dostanú ako zdroj do AI odpovede.
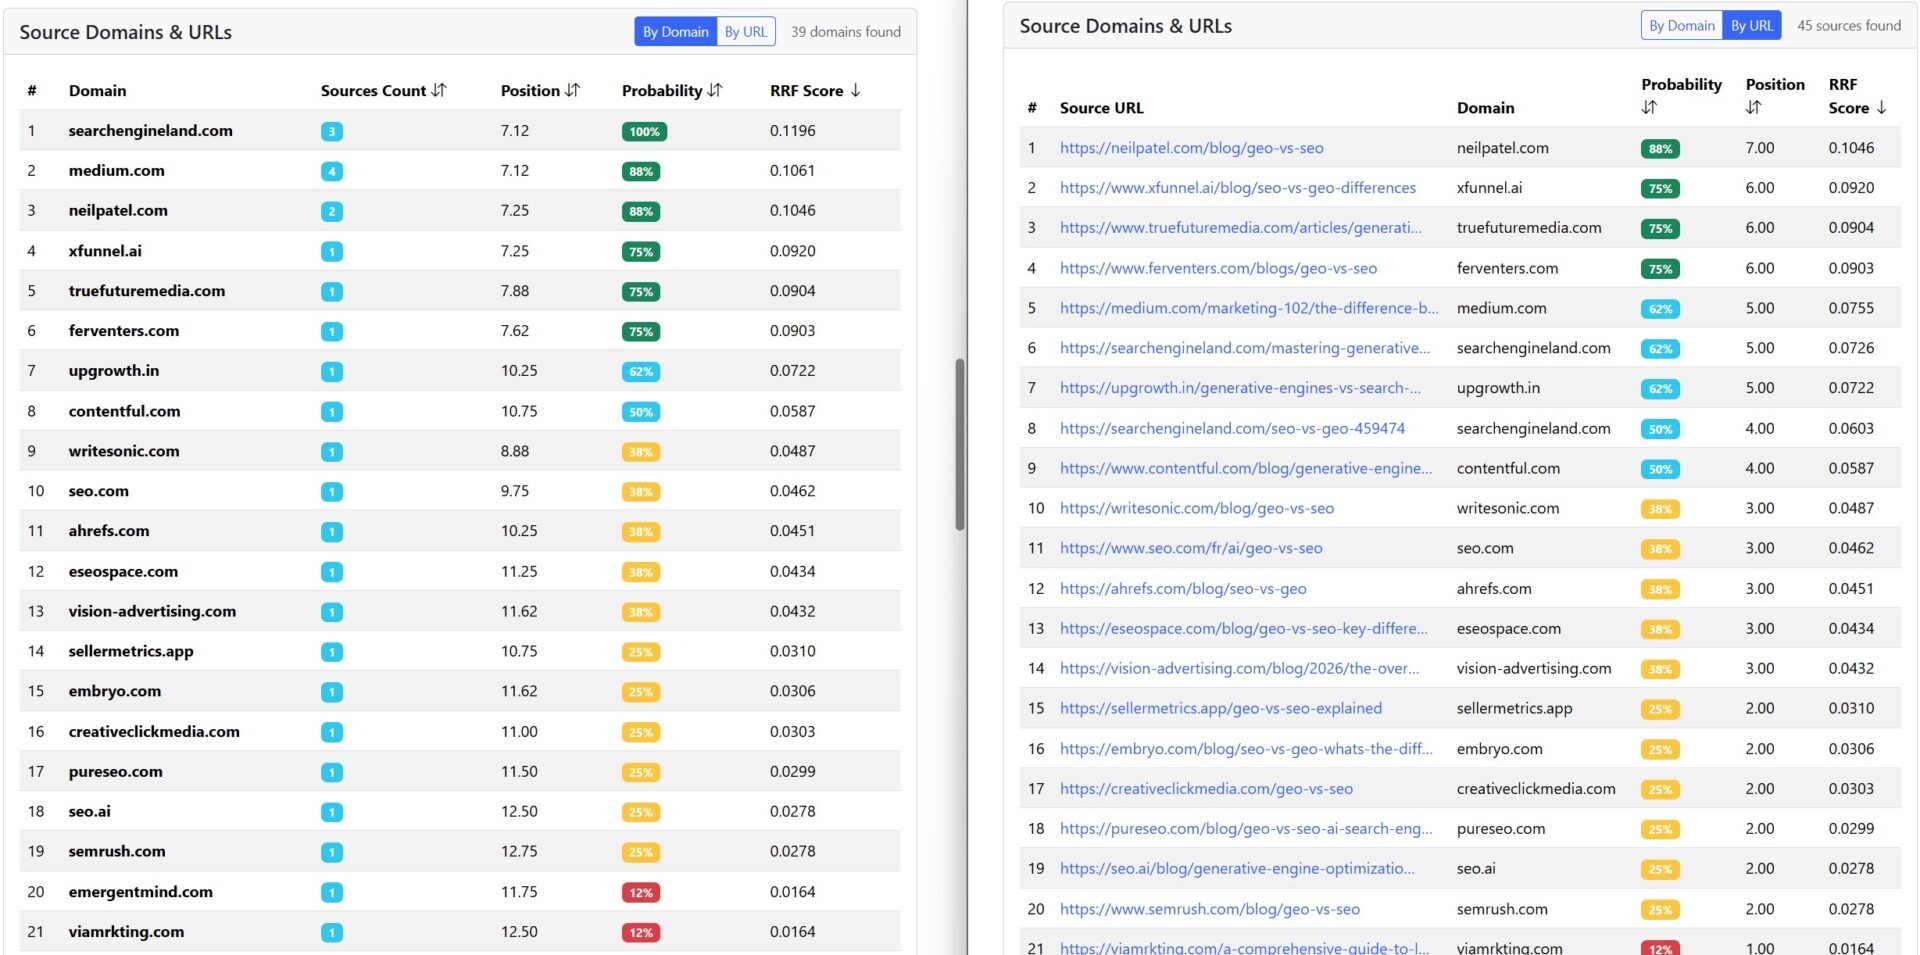
Podľa URL zdrojov napárovaných na konkrétne poddopyty.
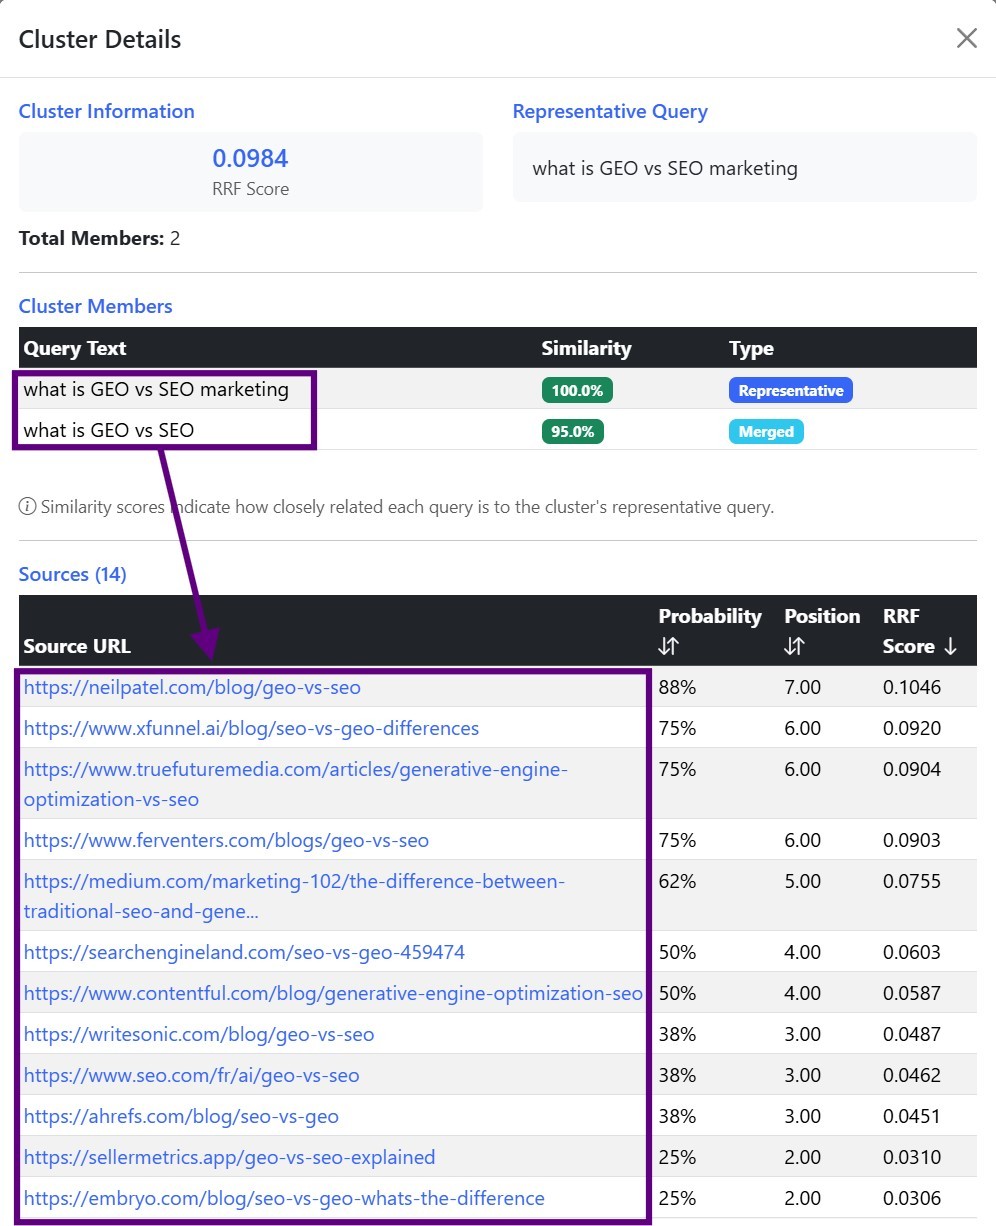
Metriky, ktoré pri zdrojoch riešime, sú:
- Pravdepodobnosť, že sa zdroj použije v AI pre daný hlavný výraz.
- Priemerná pozícia, keď sa zdroj použil v AI odpovedi.
- RRF skóre, ktoré spája pravdepodobnosť a pozíciu.
Entity v rámci query fan-out procesu
QueryTool.ai trackuje aj entity, ktoré boli zmienené priamo v odpovediach AI.
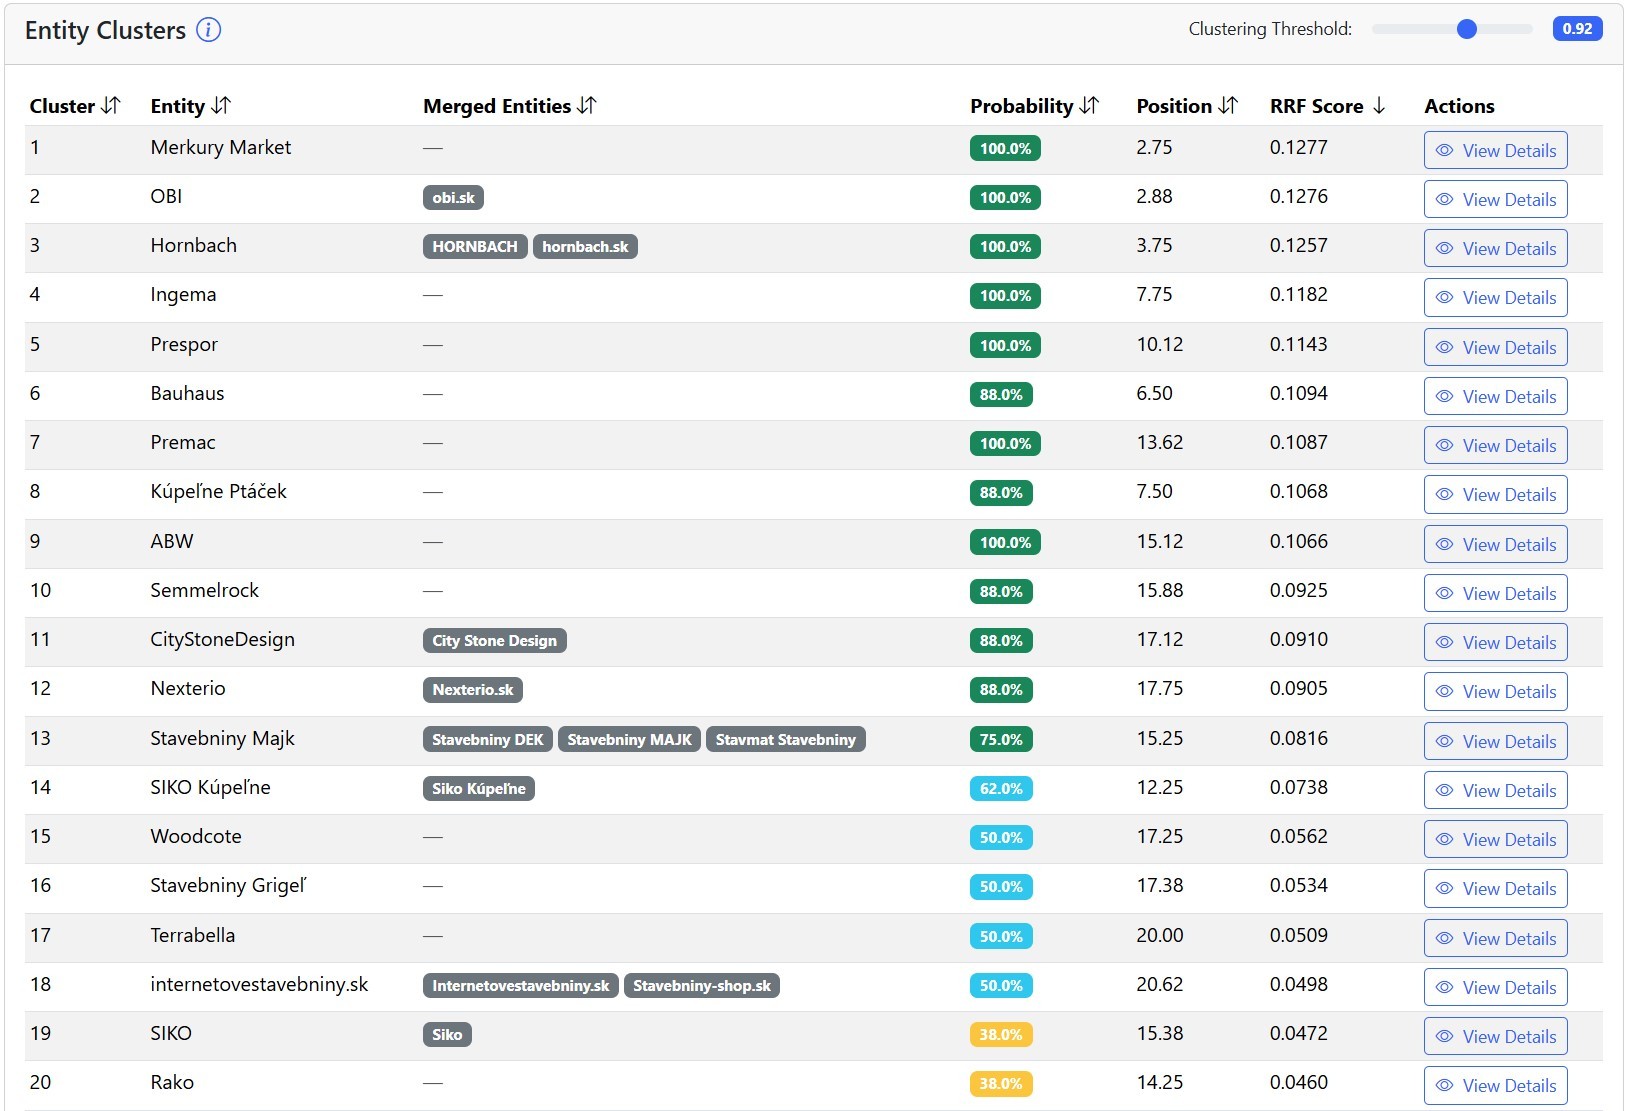
Toto je výborné pre AI prompt tracking, ale zatiaľ to nemáme pospájané na nejaký graf. Bude to dostupné behom mesiaca-dvoch. Zatiaľ si povedzme, že ak váš AI prompt tracker nesleduje odpovede v niekoľkých behoch a nevyhodnocuje pravdepodobnosti, tak z veľkej miery sledujete len náhodu.
Pre entity sledujeme tie isté metriky ako pri zdrojoch:
- Pravdepodobnosť, že sa entita objaví v AI odpovedi.
- Priemerná pozícia, keď sa entita objavila v AI odpovedi.
- RRF skóre, ktoré spája pravdepodobnosť a pozíciu.
Prečo potrebujeme clustering pre poddopyty a entity
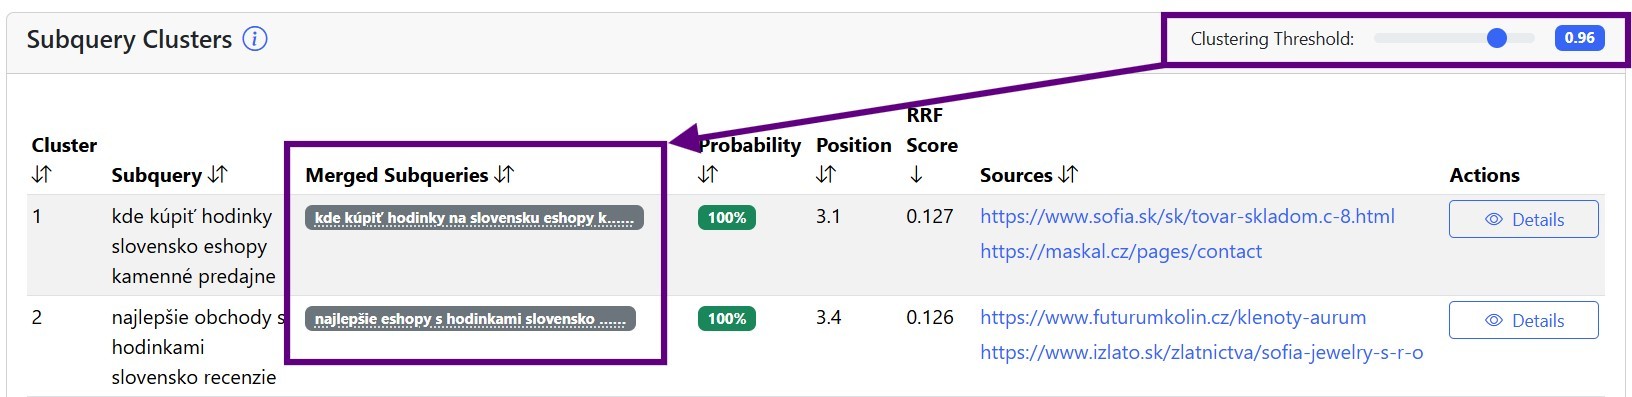
Keďže AI je pravdepodobnostné, aj keď chce vyhľadať presne to isté, použije trochu iné slová. Napr. keď hľadá výrazy „novinky v SEO 2026 Slovensko“ a „SEO novinky 2026 Slovensko“, hľadá to isté, ale trochu inými slovami. My nechceme riešiť rôzne výrazy, len pre odlišnosť slov. Chceme rovnaký význam spojiť a zistiť, ako dôležitá je tá téma, nie konkrétne slová.
Podobne pri entitách, AI raz odporučí pre ubytovanie Booking.com a inokedy ich nazve len ako Booking. Chceme vyhodnocovať entity, nie rôzne názvy tej istej entity.
Preto má QueryTool.ai nastavený clustering na nejaké rozumné východzie hodnoty, ktoré si ale môžeme upraviť podľa potreby.
Čo je dobrý počet behov v QueryTool.ai?
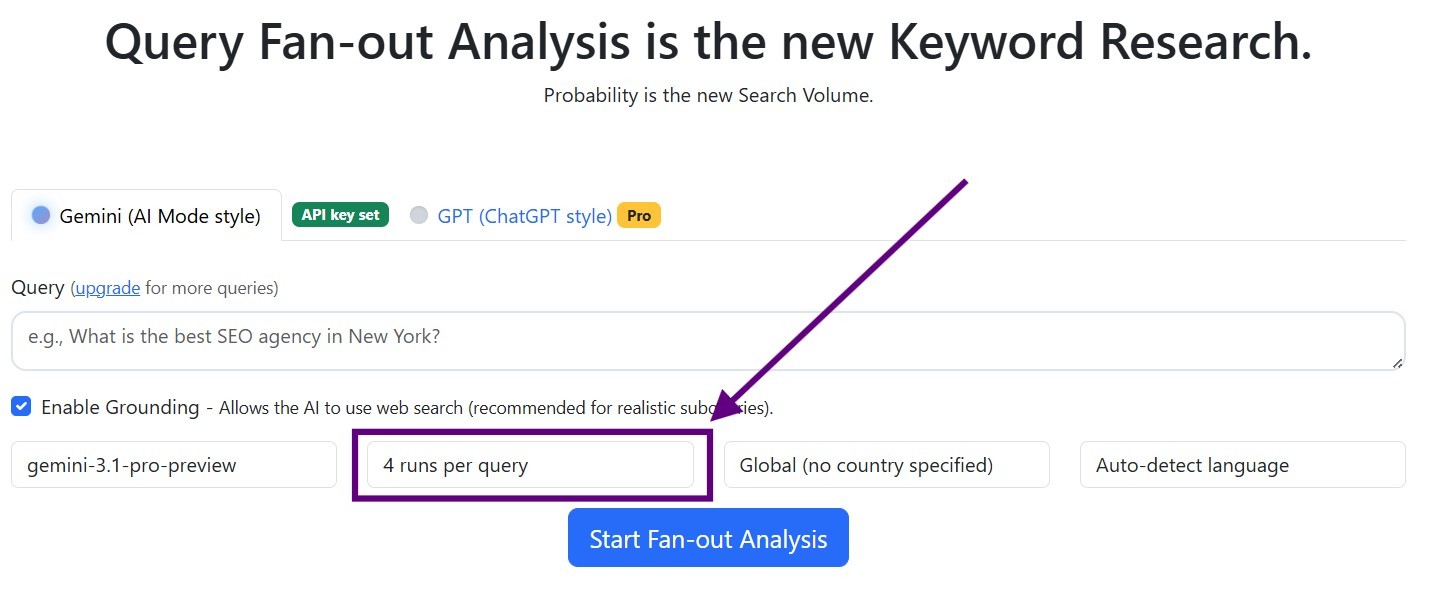
Čím viac behov pri query fan-out analýze spravíte, tým presnejšie výsledky máte, ale tým drahšie to je. Hľadáme preto čo najnižší počet behov, ktorý nás privedie k niečomu rozumnému:
- 80% poddopytov, ktoré vychádzajú dôležité po 50 behoch, sa väčšinou ukážu dôležité už po 4 behoch. Teda objavia sa aspoň 2-krát v 4 behoch.
- Sweet spot sme určili ako 8 behov, kedy odchytíte vyše 90% dôležitých poddopytov.
- 20, 30 či 50 behov nemá zmysel vzhľadom na to, čo odhalíte vs koľko to stojí. Ale pokojne skúšajte, ak vás to zaujíma a máte na to rozpočet.
TOP entity
Pre určenie TOP entít je to trochu zložitejšie. Pravdepodobnosti a pozície sa tam omnoho ťažšie ustaľujú. Interné hausnumero máme, že po 8 behoch sa zvykne ustáliť TOP3-ka. Tzn. že pohyby mimo TOP3 považujeme za náhodu a keď sa pri 8 behoch dostaneme do TOP3, tak to reportujeme klientovi ako nejaký výsledok.
Koľko stojí dôkladná query fan-out analýza?
Cena query fan-out analýzy sa skladá z ceny nástroja QueryTool.ai a ceny za tokeny cez vaše API.
1. QueryTool.ai je pre bežných používateľov zadarmo
Ak potrebujete používať nástroj viac, tak začína na 29 eur mesačne.
2. Cena tokenov cez vaše vlastné API key
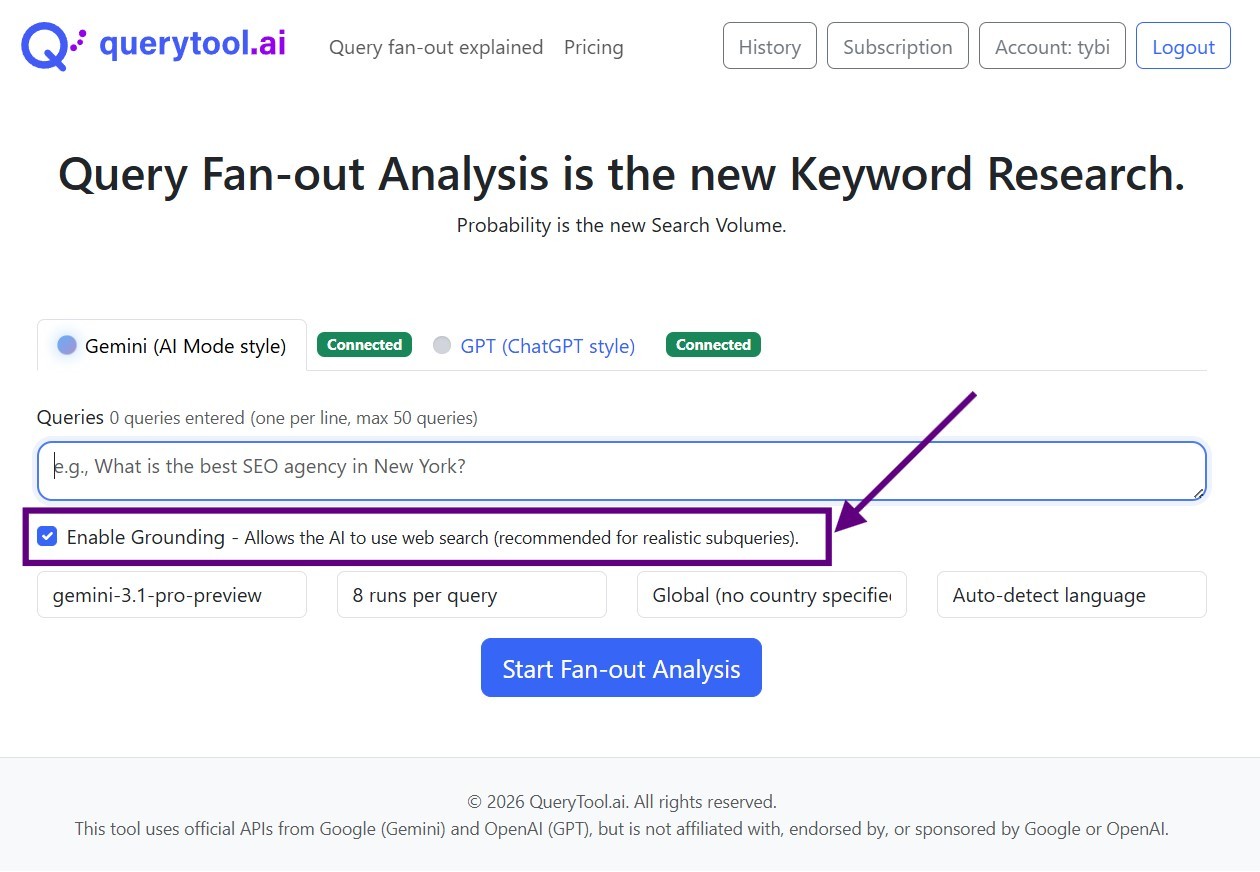
QueryTool.ai využíva vaše API kľúče, pretože je to takto lacnejšie. Každý používateľ má pre Gemini modely 5000 groundingov mesačne zadarmo, potom sa cena za query fan-out analýzu výrazne zvyšuje.
Za jedno stlačenie tlačidla “Start fan-out analysis”, teda východzích 8 behov pre jedno query, zaplatíte Googlu alebo OpenAI od 4 do 10 centov. V nepravdepodobnom scenári, že miniete 5000 volaní za mesiac, cena za 8 runov vyjde až na 40 až 100 centov. Preto má QueryTool.ai možnosť vypnúť grounding, ale teda získané subqueries budú potom horšej kvality.
Gradeta ako SEO agentúra, ktorá to používa na dennej báze pre menšie desiatky klientov, míňa cez QueryTool.ai tak do 50 eur na API.
Ale veď je to pomalé
Áno, jeden query fan-out top modelu Gemini alebo GPT s 8 behmi trvá skoro minútu a niekedy aj viac. Modely totiž cez API odpovedajú rôznou rýchlosťou a opakovane.
Ale to, čo nevidíte, je, koľko času to šetrí. Namiesto toho, aby ste oslovovali weby, ktoré boli ako zdroj v AI odpovedi len náhodou, viete presne, ktoré zdroje sú nakoľko dôležité. A namiesto toho, aby ste tvorili obsah pre náhodné výrazy, tvoríte obsah pre výrazy, ktoré s veľkou pravdepodobnosťou vstúpia do procesu generovania AI odpovede.
Radšej počkám minútu na query fan-out ala QueryTool.ai, než strávim hodiny naháňaním náhody.
Základné rozdiely pri query fan-out procesoch medzi AI modelmi
Toto sú najrozšírenejšie AI rozhrania a ako pristupujú ku query fan-out-u.
Google AI Overviews
AI Overviews alebo Prehľady od AI je poháňané špeciálnym modelom Gemini od Googlu, väčšinou sa ukazuje na klasické kľúčové slová (pokojne aj na niečo ako „seo“). AIO vždy použije query fan-out, tak je postavený. Ale vo všeobecnosti sa pri AIO hľadá menej subqueries ako pri AI režime na Googli a AIO sa snaží dodržiavať jazyk hľadajúceho, resp. hľadaného výrazu.
Google AI Mode
AI Mode alebo AI režim je tiež poháňaný špeciálnym modelom Gemini od Googlu, ale veci, na ktoré sa ho ľudia pýtajú, sa už omnoho viac podobajú na otázky v AI chatoch. Sú to dlhšie výrazy a často priamo otázky. AI režim by vždy mal použiť query fan-out podobne ako AIO. (V dobe písania tohto textu to nie je úplne pravda – občas sa query fan-out neurobí a AI mode odpovie z pamäte, resp. neuvedie zdroje. Myslím si, že tam má Google nejaký bug.)
V AI Mode pre tú istú otázku dostanete viac query fan-out poddopytov ako pri AIO a AI Mode sa až tak neunúva dodržať jazyk hľadajúceho, resp. hľadaného výrazu.
ChatGPT
ChatGPT je známy AI chat od OpenAI. Ľudia sa ho pýtajú na veľmi detailné veci, čiže otázky a prompty sú omnoho detailnejšie. ChatGPT všeobecne vyhľadáva v oveľa menej prípadoch ako AI režim alebo AIO a primárne sa snaží odpovedať z pamäte. V podstate hľadá len vtedy, ak potrebuje nejaké aktuálne údaje. Na výraz „čo je seo“ grounding nepoužije.
Ak už grounding použije, jeho poddopyty sú omnoho dlhšie ako pri Googláckych produktoch. Pravdepodobne preto, že jeho vyhľadávanie je horšie ako Googlácke a presnejšími výrazmi si pomáha nájsť správne výsledky. Podobne ako Google AI Mode alebo Gemini chat sa pri hľadaní informácií až tak nedrží jazyka používateľa a dopytu.
Gemini chat
Gemini chat je niečo ako ChatGPT. Veľakrát odpovedá priamo z pamäte, ale keď použije grounding, jeho subqueries sa veľmi podobajú na tie z AI Mode.
Toto sú skúsenosti na základe posledných mesiacov, nespočetných simulácií a pokusov. Samozrejme, v AI sa všetko tak rýchlo mení, že o nejakú dobu to môže byť trochu alebo úplne inak.
Ako prísť k dobrému zoznamu kľúčových promptov?
Snažiť sa uhádnuť presné prompty a fingovať, čo sa asi mohli ľudia pýtať v štýle „aký e-shop na matrace by ste odporučili? hľadám spoľahlivý obchod a matrac do 300 eur“ je podľa mňa nesprávne. Toto sa skoro nikto takto aj tak nespýta a nezmeriame vlastne nič, lebo je to príliš konkrétne.
Kľúčové prompty by mali byť čo najkonkrétnejšie vzhľadom na produkt, ale inak čo najvšeobecnejšie vzhľadom na požiadavku používateľa.
Čo najvšeobecnejšie na požiadavku používateľa znamená, že radšej jednoduché „aký eshop na matrace?“ ako „aký e-shop na matrace by ste odporučili? hľadám spoľahlivý obchod a matrac do 300 eur“. Radšej jednoduché “ako si vybrať matrac?” než “aký matrac si mám vybrať, ak som žena a mám problémy s chrbtom”.
Čo najkonkrétnejšie vzhľadom na produkt znamená, že pre online predajcu matracov je „aký eshop na matrace?“ relevantnejší kľúčový prompt ako “kde kúpiť matrac”. Pri druhej otázke môže totiž AI zvažovať aj lokálne predajne, nie len eshopy.
Analyzované a trackované otázky by mali vyplývať najmä z analýzy kľúčových slov. V kľúčových slovách nájdete plno otázok, len inak položených. Ďalšie možnosti sú aj našepkávače rôznych AI rozhraní ako Grok, Perplexity, apod., fóra a diskusie, sociálne siete, chat na webe, interné prieskumy a ďalšie. Konkrétne príklady ako na to možno raz vo zvláštnom článku.
Dôvetok
AI SEO sa neustále vyvíja, ale už vidno niektoré systematické procesy, taktiky a stratégie, ktoré pretrvávajú. Query fan-out je jedna z nich.
Query fan-out analýzu používame dlhé mesiace a máme s ňou úžasné výsledky. Zvýšenie návštev z ChatGPT o tisícky percent ste už všelikde videli. Ale to sotva ohúri, keď porovnávacia báza bola pár návštev z minulého roka.
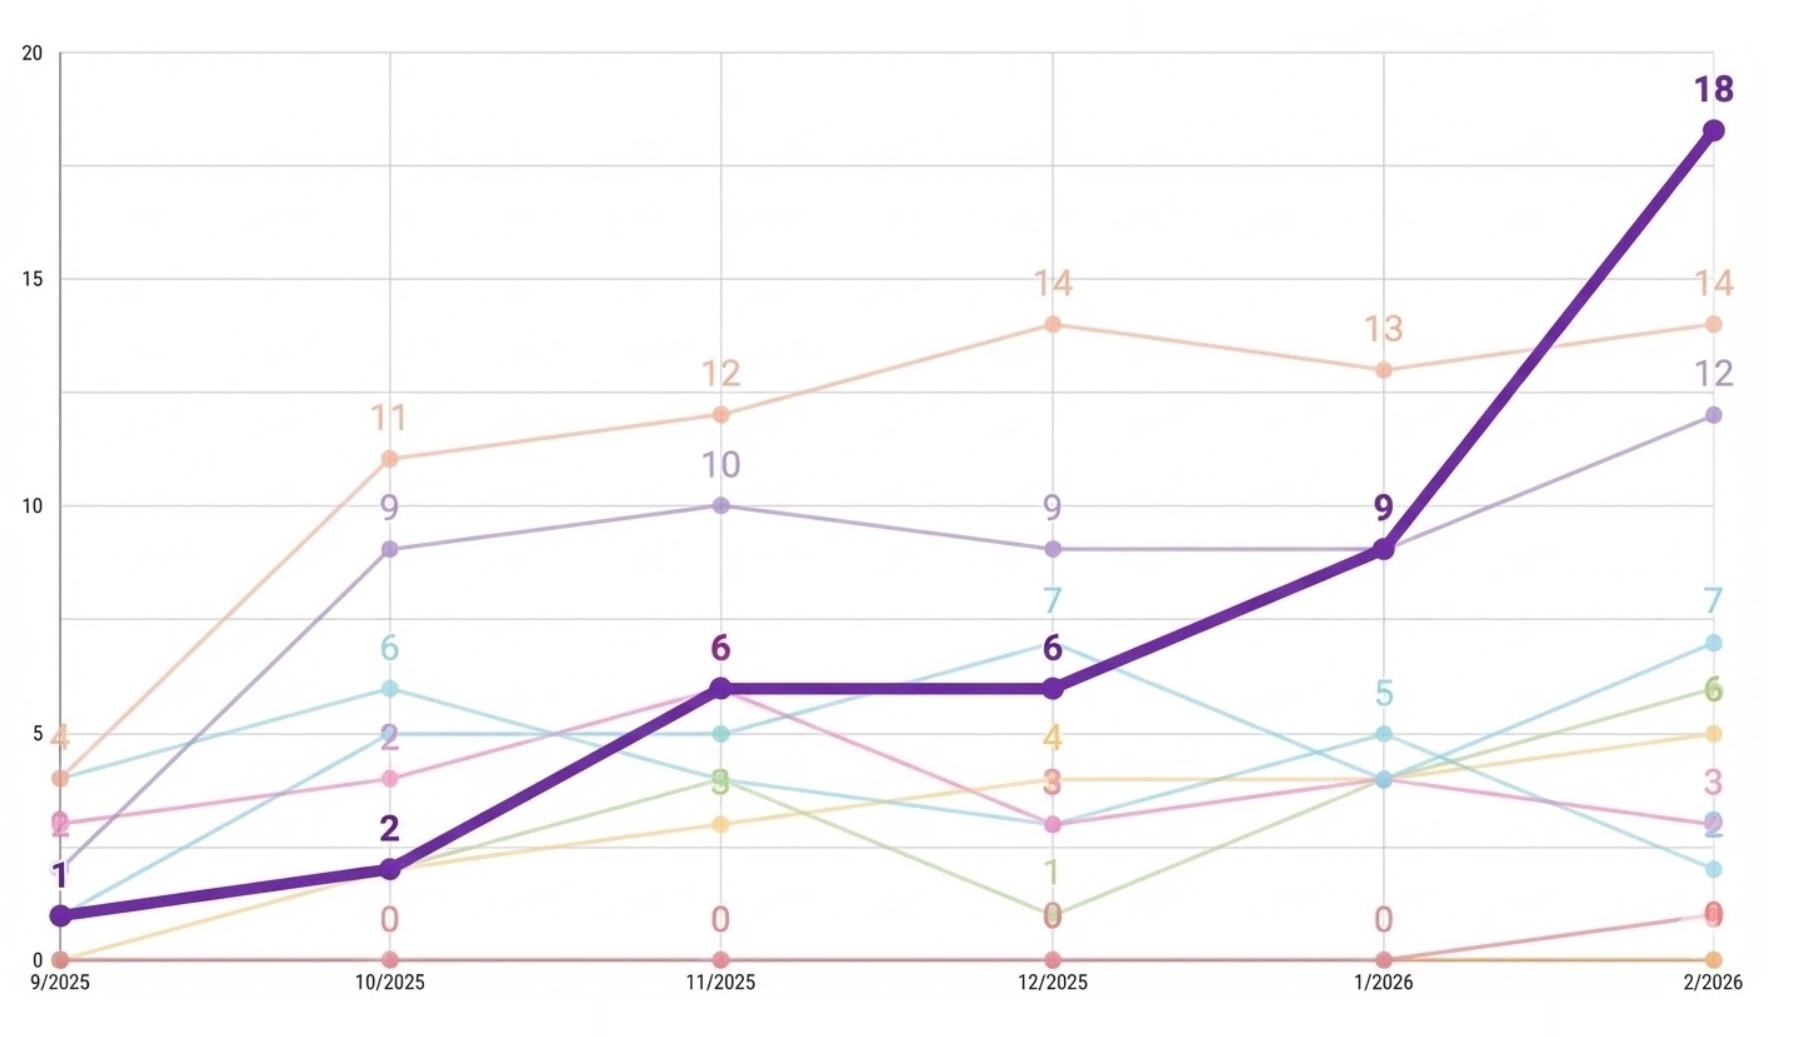
Skôr som hrdý na takéto… Biznis s cestovaním, v ktorom sa na výrazy komerčného charakteru ukazujú AI Overviews. Trackujeme preto v Ahrefs obsadené AI Overviews a porovnávame sa s konkurentmi. Začali sme na tom pracovať v septembri, z predposlednej pozície sme sa vypracovali na prvú behom 6 mesiacov. Predbehli sme pritom oveľa väčšie autority ako klientov web.
Komentáre